東京リージョンで Amazon Textract が日本語の書類をそのまま読んでくれた。それだけのことなのに、結果を目で見た瞬間にじわっとくるものがあった。「お見積書」「令和8年10月30日」「東京都千代田区丸の内一丁目二番三号」——自分で作ったサンプルとはいえ、これが ap-northeast-1 のエンドポイントから返ってきた JSON に入っている光景は、なかなか感慨深い。これまでバージニア(us-east-1)へ投げるか、別のサービスを組み合わせるかを考えていたのが、その心配がなくなった。
10月30日は AccessDenied、11月1日に通った
10月30日に、自作の Python ツールで日本語サンプル5枚を東京リージョンの DetectDocumentText に投げたところ、全部 AccessDeniedException で返ってきた。権限の問題かと思って IAM を確認したが、設定は問題ない。念のため同じ画像を us-east-1 に向けると、あっさり通った。そのときは「ああ、東京はまだ対応していないのか」と諦めて、その日はバージニアで作業を続けた。
aws textract detect-document-text \
  --document '{"S3Object":{"Bucket":"my-bucket","Name":"sample.png"}}' \
  --region ap-northeast-1
11月1日に同じスクリプトをそのまま走らせたら、何事もなく通った。コードは一行も変えていない。変わったのはリージョン側だけ。5枚全部が返ってきて、続けて AnalyzeDocument(LAYOUT と TABLES)も東京で問題なく動いた。この2日間の差は権限でも設定でもなく、単純にサービスの提供状況の変化だったと思う。細かい経緯は追っていないし、公式の発表日なども確認していないので、タイミングの話だけにとどめておく。
見積書と表が読めた、これが「使える」の実感
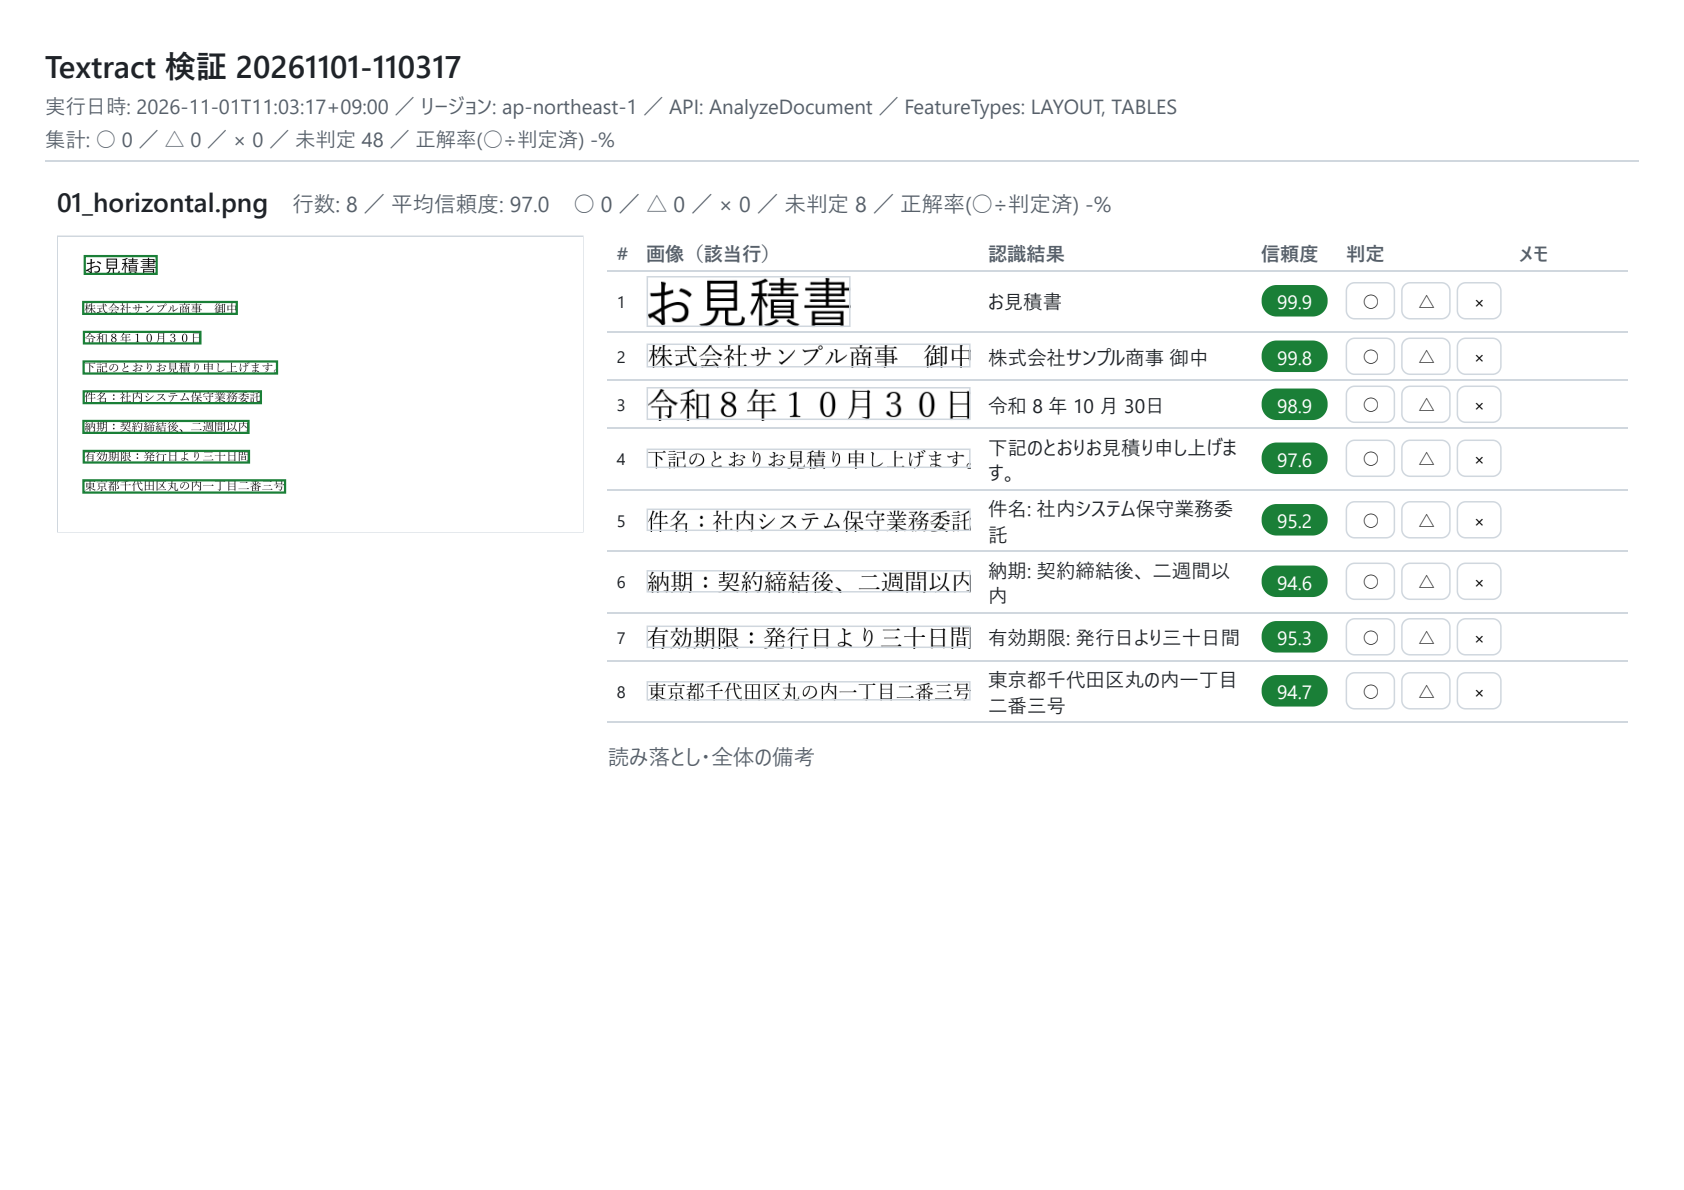
最初に通したのは、游ゴシックと游明朝で作った横書きの見積書サンプルだ。「お見積書」「株式会社サンプル商事 御中」「社内システム保守業務委託」といった行が、8行の平均信頼度約97で返ってきた。本文はほぼそのまま読める。和暦の「令和8年10月30日」は漢数字の一部が算用数字に変換されていたが、内容として壊れているわけではない。
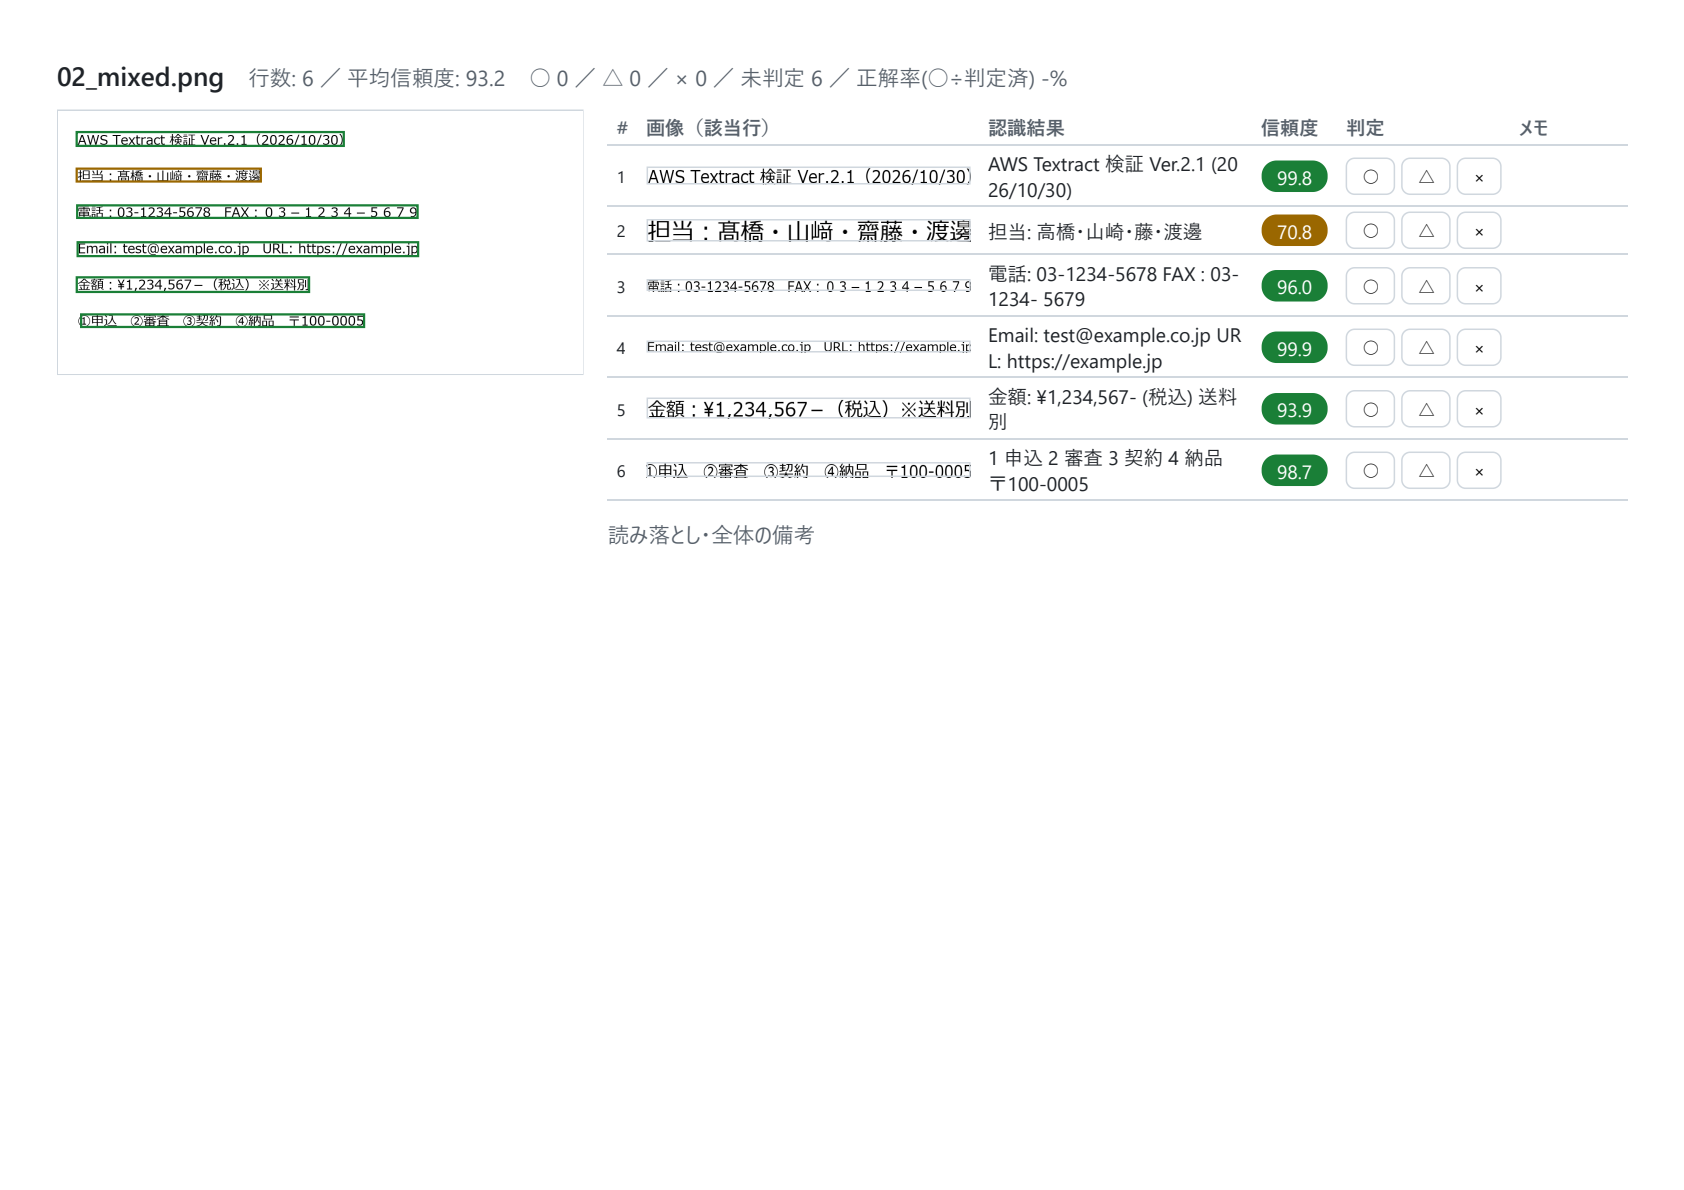
英数字・記号・旧字が混在するサンプルも試した。「AWS Textract 検証 Ver.2.1」「03-1234-5678」「test@example.co.jp」「¥1,234,567」「〒100-0005」あたりは問題なく読めた。平均信頼度は約93。丸数字(①②③④)は普通の算用数字になったが、これは許容範囲だと思う。
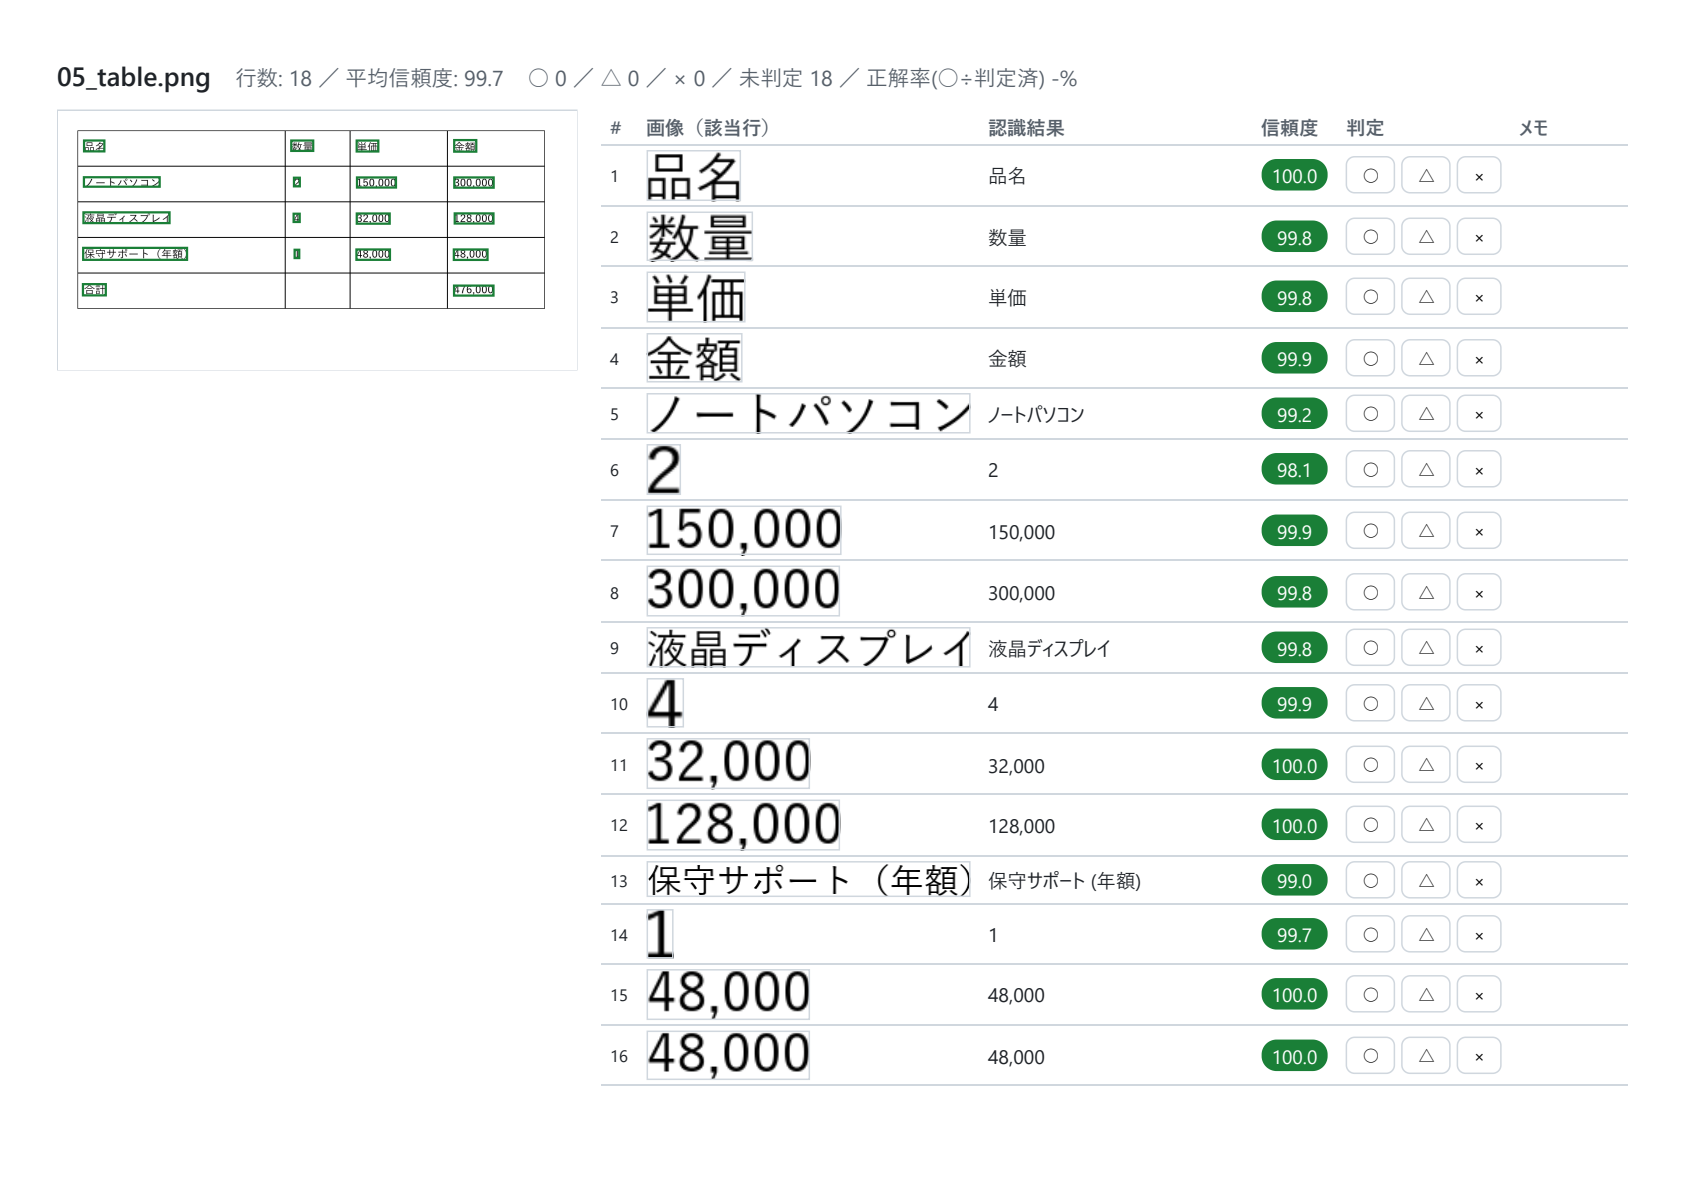
次に試したのが罫線付きの明細表。品名・数量・単価・金額の列に、ノートパソコン、液晶ディスプレイ、保守サポート(年額)、合計476,000円を並べたシンプルなものだ。AnalyzeDocument に TABLES を指定すると、セル単位でテキストが取れた。これが地味に嬉しかった。テキスト抽出だけなら行の並びを自分でパースする必要があるが、テーブル構造ごと返ってくるとその手間がかなり省ける。金額のような数字が多い表でも、セルの対応関係が崩れずに取れていた。
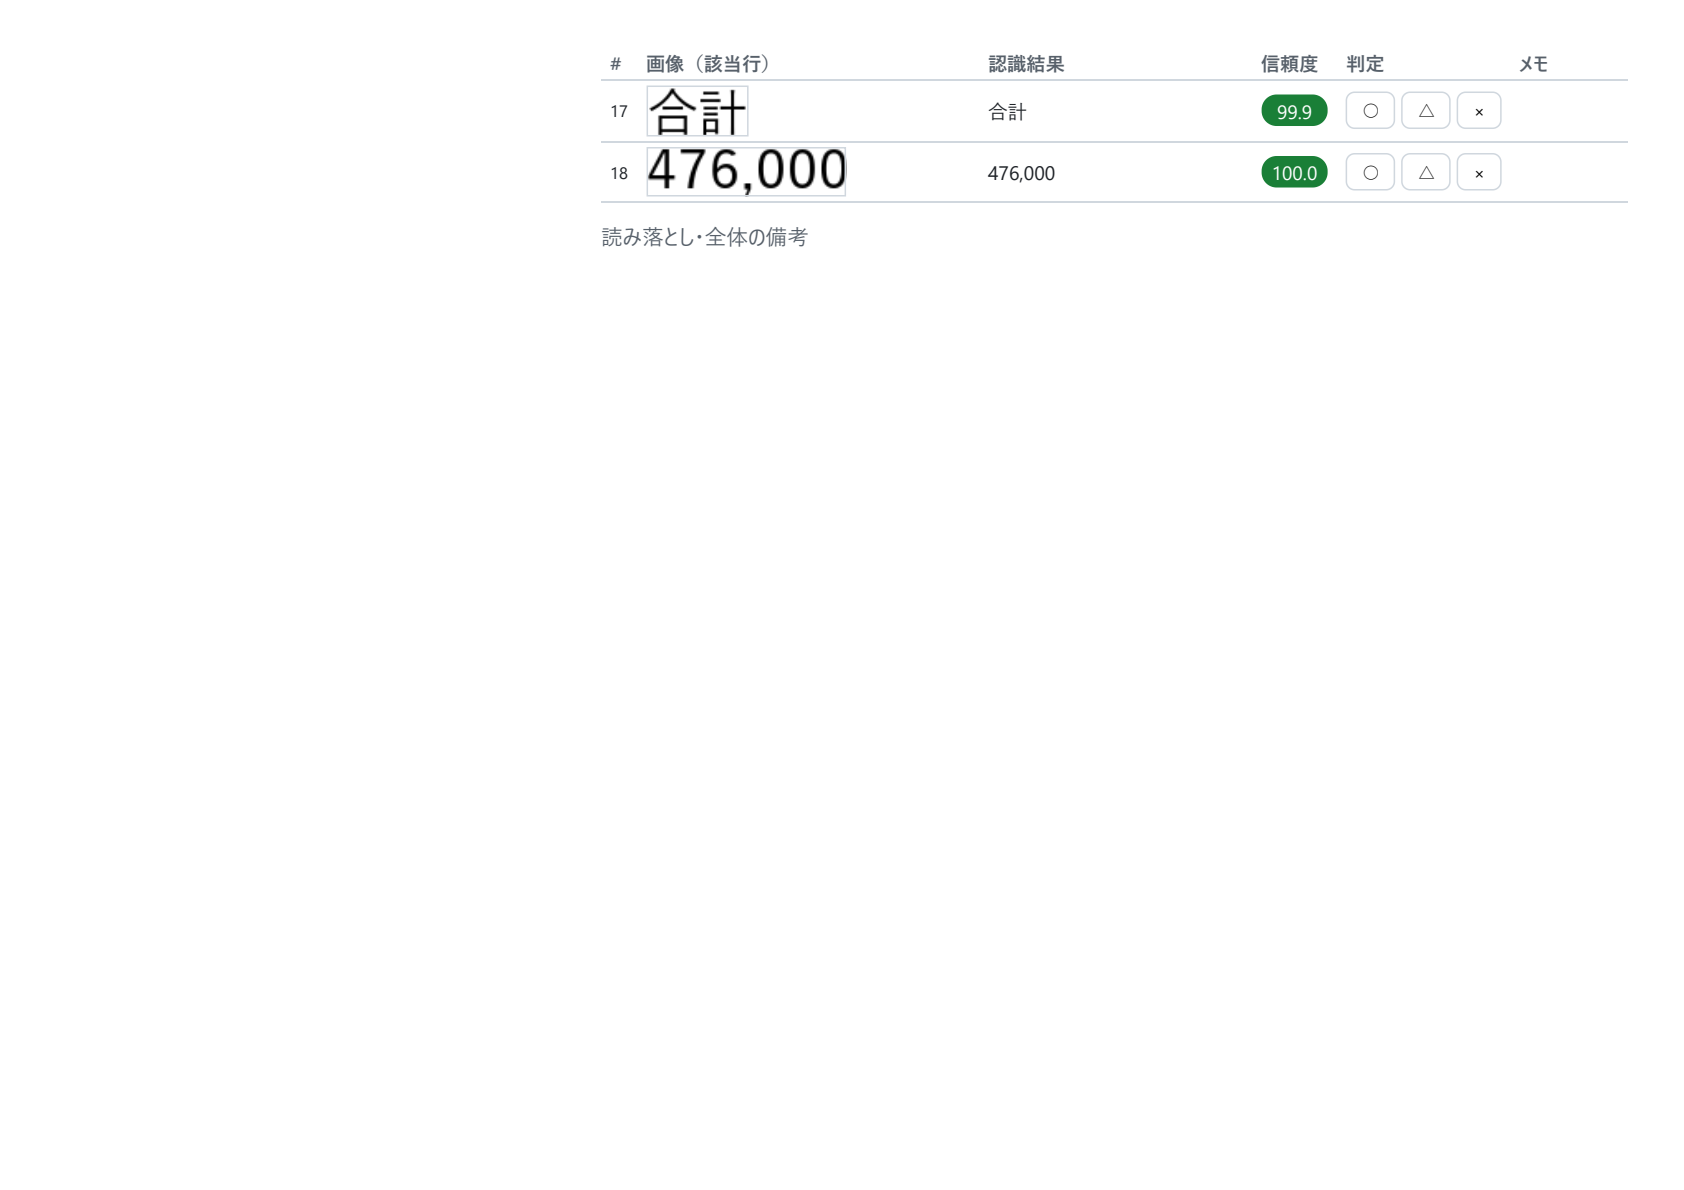
「合計」行と金額の認識結果を拡大したのが下の画像だ。行17「合計」が信頼度99.9、行18「476,000」が信頼度100.0。合計行のような太字・大きめのフォントでも精度は落ちていない。
崩れたケース——万能ではない
正直に書いておくと、うまくいかなかったパターンも2つある。
ひとつは縦書き。「吾輩は猫である。名前はまだ無い。」を1文字ずつ縦に並べたサンプルを送ったところ、平均信頼度は約71で、行としてほぼ復元できなかった。縦書きのレイアウト解析はまだ厳しいようだ。古い書類や和文縦組みのPDFをそのまま投げるのは、今の時点では期待しすぎになる。

もうひとつは旧字体を含む行。「髙橋・山﨑・齋藤・渡邊」を入れたサンプルでは、「髙橋」が「高橋」、「山﨑」が「山崎」に寄った。「齋藤」は「藤」だけになってしまった。旧字・異体字は常用漢字側に引き寄せられるか、一部が脱落する傾向がある。戸籍や固有名詞を扱う場面では、そのまま使うのは難しいと感じた。
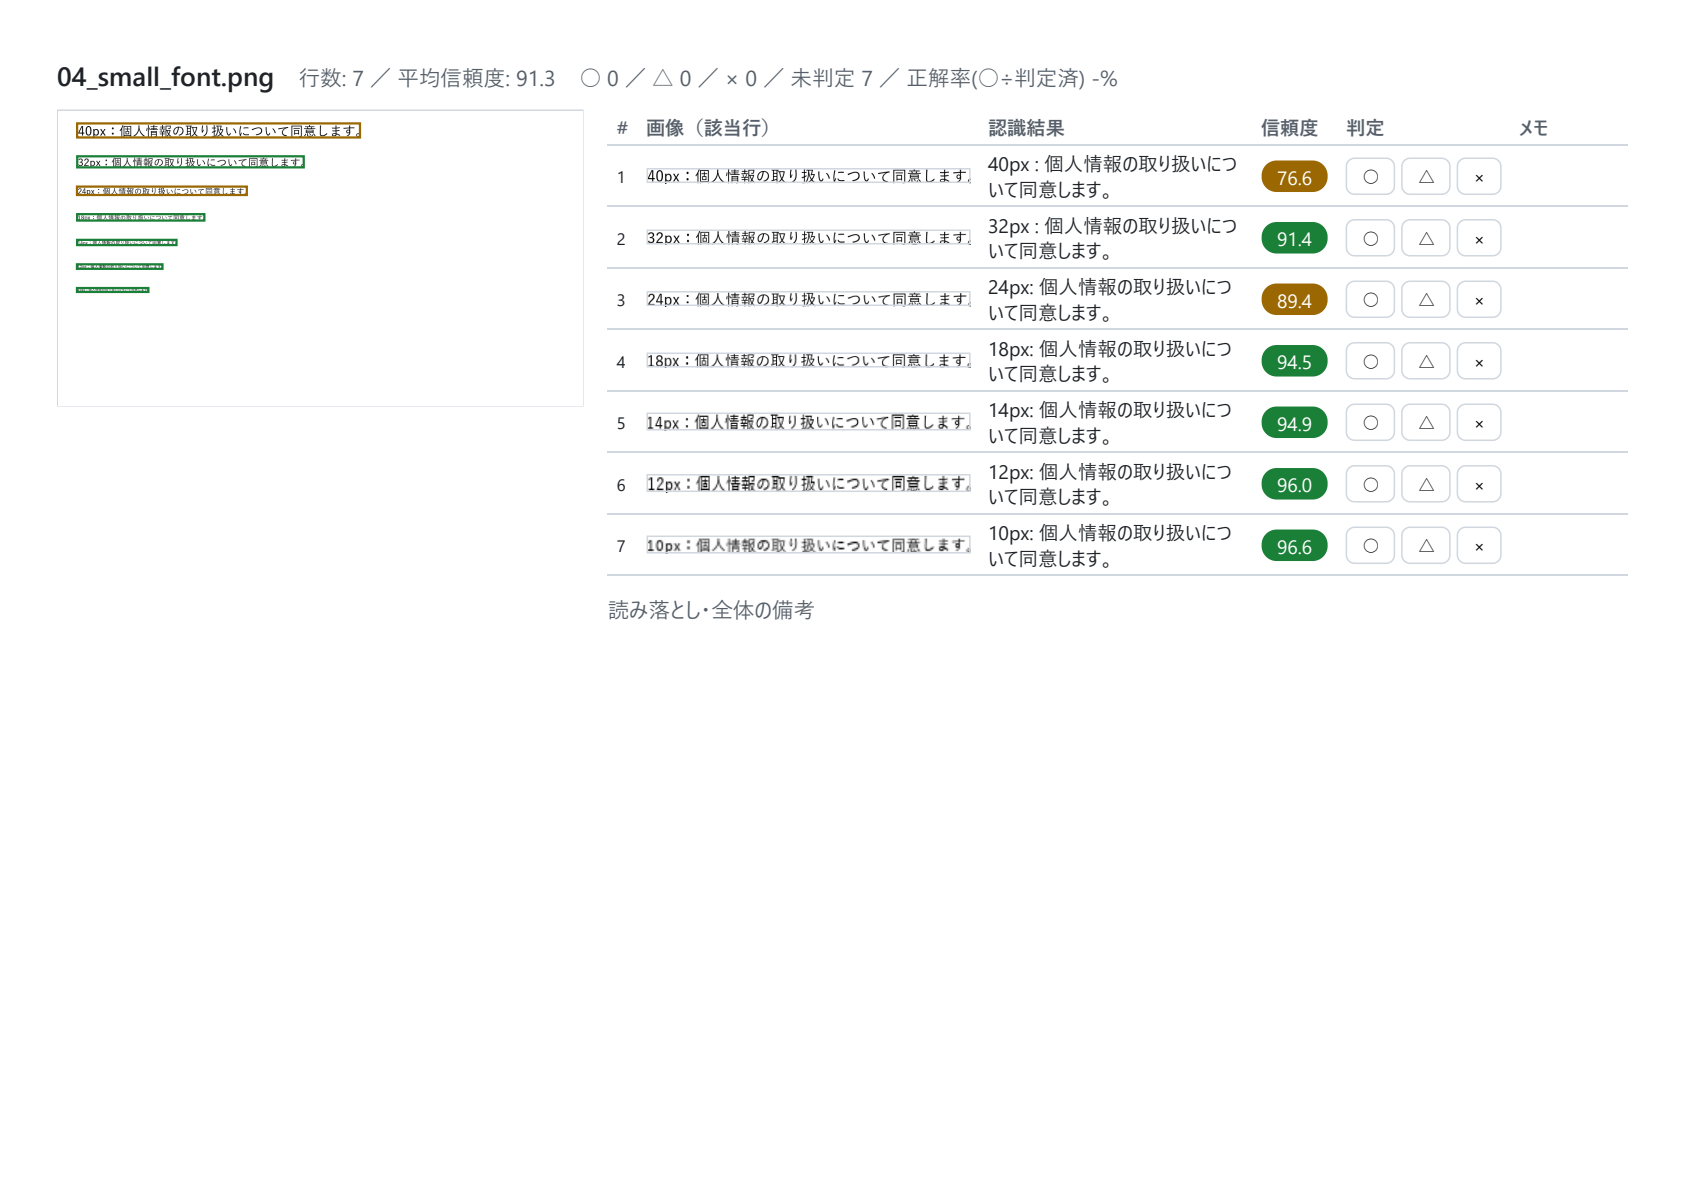
フォントサイズのサンプル(40pxから10pxまで同じ文字列を縮小したもの)では、10pxまで読めた。ただし40pxの行の信頼度が約77と一番低く、小さいほど読めるという単純な話ではない。サイズと信頼度の関係は、画像の解像度や余白など他の要因も絡むので、一般化しないほうがよさそうだ。
東京リージョンのまま完結できる
今回の一番の収穫は、自分で作った日本語の書類を ap-northeast-1 のまま扱えるようになったことだ。バージニアに投げていたころは、データをリージョン外に出すことへの気持ち悪さが常にあった。それが解消されたのは、小さいようで大きい。
見積書や明細表のような横書き・フォームベースの書類は、信頼度も高く実用的な精度だと感じた。旧字・縦書きは今の段階では厳しい。次は、自分で作った画像ではなく、写真やスキャンした印刷物で同じ検証をしてみたいと思っている。